五个「唯一」
数据入口、触发、应用入口、账号权限、用量上限,各只留一个。
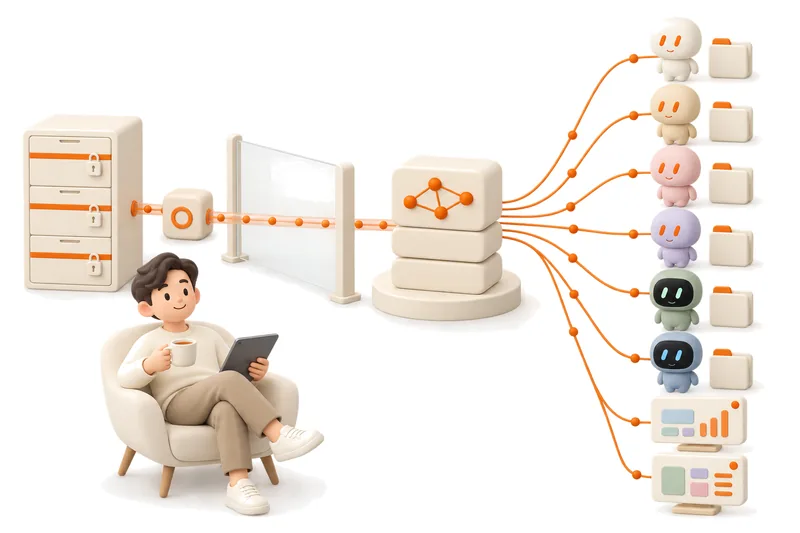
本课目标
读完这一课,你将能够
- 说出统一平台的五个「唯一」,以及各自由 AIDC 的哪一部分承担
- 用五个「唯一」检查一套系统:每一项现在有几处
- 说出为什么「让旁路不存在」比「管好每条旁路」更可靠
与其管好每条路,不如只留一条
直连加轮询的根子是路太多。每多一条路,就多一份要盯的东西:多一份凭证,多一个定时器,多一个站点。管好每条路的成本,会随路的数量一起涨。
统一平台的做法相反:让路只剩一条。不是把旧的路管得更好,而是让它们不再存在。
- 01数据源ERP、MES、OA,永远只读
- 02发布端装在数据源旁,只出站
- 03Semantic镜像、语义本体、访问
- 04工作流的触发数据一变、到点、有人点
- 05Nexus 应用智能体和人都从这里用
从左到右,每一段只有一个入口。没有一条线从应用或智能体直接连到数据源。
五个「唯一」
| 以前 | 以后 | |
|---|---|---|
| 数据入口 | 每个脚本、每个智能体各自直连 | 只有发布端读数据源,其余都读 Semantic |
| 触发 | 定时器、crontab、轮询循环各自触发 | 只写在工作流里:数据一变、到点、有人点 |
| 应用入口 | 每个团队各建一个报告站点 | Nexus 应用,一个目录 |
| 账号与权限 | 每个站点自己的登录和权限 | 一个 AIDC 账号体系,开放程度四档、角色三种 |
| 用量与上限 | 各自的服务器和账单,没人知道花了多少 | 每个应用有计算分钟、通知等上限,用量看得见 |
这五项分别落在 Semantic(数据)、工作流(触发)、Nexus(应用入口)、Console 与 Semantic 的访问设置(账号与权限)、发布 SDK 的资源上限(用量)上。
每个「唯一」怎么守住
「唯一」不能靠自觉,要靠机器拦得住的地方:
- 数据入口:数据源只给发布端一个只读账号;发布 Key 只能往一条数据流发布,泄露了也读不了别的;智能体和应用没有数据源的凭证。
- 触发:触发只写在工作流的
trigger里。部署时,比每 5 分钟还密的定时被拒收,5 分钟到 1 小时一次的一定告警。 - 应用入口:应用先进 test 通道,再发布到 Nexus 的正式通道;用了没登记的 SDK,部署直接拒收。
- 账号与权限:用 SDK 或应用做任何事都要先登录;分享只有 Owner 能改。
- 用量与上限:每个应用缺省每月 2,000 计算分钟、每天 20 封通知;计算分钟用完,请求返回
429 quota_exhausted。
拿它检查自己的系统
最简单的检查,是给每一项数个数:数据源有几处入口?触发写在几个地方?报告站点有几个?登录系统有几套?数完,先收数字最大的那一项。
- 数
五项各数一个数,写在一张纸上。
- 选
挑数字最大、也最容易出事的一项。
- 收
先建替代物,再并行对账,最后下线旧的——第 6 课讲这个顺序。
要点
- 路太多是根子:与其管好每条路,不如让路只剩一条。
- 五个「唯一」:数据入口、触发、应用入口、账号与权限、用量与上限。
- 每一个都靠机器拦得住的地方守住:凭证、部署检查、登录、上限。
- 先给每一项数个数,再从数字最大的一项开始收。
练一练
给你的系统打一张分
用同一个业务系统,做第 1 课盘点的下一步。
画一张五行两列的表:五个「唯一」,每一项写下你的系统现在有几处。
挑数字最大的一项,写一句话:把它收成一处,会去掉哪些东西。
为这一项写出「靠什么拦得住」:是凭证、部署检查、登录,还是上限?
小测
选一个答案,马上看解析。
Q1为什么说「让旁路不存在」比「管好每条旁路」更可靠?
管理是在旁路存在的前提下做事;让它不存在,才是让问题没有地方再长出来。
Q2下面哪一项属于「用量与上限」这个唯一?
发布 Key 守的是数据入口,登录守的是账号与权限;计算分钟上限守的是用量。
Q3在这套设计里,应用和智能体怎样拿到数据源里的数据?
数据源只给发布端一个只读账号;其余所有读取都落在 Semantic 上。